Можно ли автоматизировать разбор и устранение инцидентов: опыт AAA
Можно ли в небольшой команде финтех-продукта с ограниченным бюджетом внедрить автоматический — или хотя бы полуавтоматический — разбор и устранение production-инцидентов с помощью Codex?

Вопрос эксперимента звучал так: можно ли в команде финтех-продукта из одного разработчика и одного инженера поддержки (он же тестировщик), без выделенного системного администратора (да, такое бывает), но с одним человеком, внедрявшим AI-подход, — Данилом — достаточно быстро и качественно пройти путь от первых фактов до проверенного исправления с помощью Codex, не внедряя отдельную тяжёлую платформу и сложный процесс?
Под ограниченным бюджетом здесь имеется в виду конкретное ограничение: без отдельной команды надёжности и новой специализированной платформы, с уже имевшимися Mattermost, Docmost, Google Sheets, GitHub и регулярными встречами. Экономию в рублях мы не измеряли, поэтому этот кейс не доказывает финансовую окупаемость.
Это не заранее спроектированный лабораторный тест. Работа уже произошла, а мы ретроспективно восстановили по её следам пять инцидентов AAA 2026 года, в паспортах которых прямо назван Codex. Проверяли, мог ли агент собрать факты, проверить гипотезы, найти причину и подготовить путь к исправлению. Отдельно смотрели, что действительно сделал Codex, что выполнили другие AI-модели, а что осталось людям.
AI-трансформация в AAA началась с более приземлённого шага — внедрения корпоративного мессенджера. Сначала команда неделю экспериментировала с Matrix, немного поплакала и поставила Mattermost. Этому решению мы до сих пор рады: обсуждения перестали теряться, у инцидентов появились отдельный канал и треды, а позже это рабочее пространство стало основой для агентной автоматизации.
Что именно проверяли
| Критерий | Как понимали результат |
|---|---|
| Качество | Факты отделены от предположений, причина подтверждена наблюдениями, для изменения есть проверка |
| Скорость | Восстанавливаемое время до оценки масштаба, подтверждённой причины, восстановления и проверенного исправления |
| Участие человека | Какие сведения, решения, проверки и действия в production нельзя было безопасно передать агенту |
| Цена минимализма | Какие инструменты, данные и правила всё равно понадобились без отдельной команды и платформы управления инцидентами |
Там, где временных меток или доказательств не осталось, мы не подставляли оценки задним числом.
Как выглядел минимальный процесс
Все материалы об инцидент-менеджменте собраны в одном разделе: кейс, схема процесса, шаблон PIR и журнал.
У каждого инцидента появлялось одно корневое сообщение в Mattermost и отдельный документ Post-Incident Review (PIR) — разбор с симптомом, влиянием, хронологией, причиной и действиями на будущее.
В журнал заносили любое событие, мешавшее вести операционную деятельность, а не только падение production или дефект в коде. Поэтому среди PIR есть сбои инфраструктуры и доступности, ошибки в курсах, организационные и архитектурные проблемы, события безопасности, сетевые проблемы и даже ложные инциденты.
Статус читался прямо по реакциям под корневым сообщением: 👀 означал, что инженер увидел проблему и взял её в работу; 🏁 — что исправление или обходной путь готов и его можно проверять; ✅ — что восстановление подтверждено и пользовательский сценарий снова работает. Всё последующее обсуждение шло в треде этого сообщения.
Минимальный процесс работы с инцидентом показан отдельной схемой: от сообщения в корпоративном канале и создания PIR до текущего исправления, регулярных разборов и закрытия предотвращающих задач.
Восстановление сервиса не равно закрытию PIR. Сервис может снова заработать через минуты или часы, но паспорт остаётся открытым, пока не выполнены и не проверены задачи, предотвращающие повторение. Самого разбора и списка задач для закрытия недостаточно.
Это критерий процесса, а не доказательство того, что каждая историческая строка реестра была закрыта именно так. Полнота статусов и дат оказалась одним из ограничений эксперимента.
Из сложного процесса управления инцидентами мы оставили только необходимый след: что произошло, на чём основан вывод, что восстановило работу и какое изменение должно не допустить повторения.
Шаблон PIR вынесен в отдельный артефакт: его можно просмотреть на сайте и скачать в исходном формате Markdown.

Реестр отдельно от разбора
Mattermost отвечал на вопрос «что происходит сейчас», а отдельный журнал в Google Sheets — «в каком состоянии находятся все зарегистрированные инциденты». Одна строка соответствовала одному PIR и связывала номер и название инцидента, затронутый сервис, инцидент-менеджера, статус, четыре контрольные даты, последующие задачи, оценку потерь и длительность.
На практике дату и время восстановления часто не заполняли: во время сбоя было просто некогда, а после восстановления возвращаться к строке уже не казалось нужным — восстановили и ладно. Даты создания и закрытия задач, предотвращающих повторение, позднее можно было восстановить по связанным GitHub Issues, PR и релизам. Но время фактического восстановления нельзя автоматически подменять датой merge или ближайшей встречи: для него требовалось отдельное подтверждение в PIR, треде, логах или сообщении оператора.
Сам разбор в таблицу не помещали. Факты, хронология, проверка гипотез, анализ корневых причин (Root Cause Analysis, RCA) и предотвращающие действия оставались в паспорте PIR в Docmost. Благодаря этому реестр можно было быстро фильтровать и обсуждать на регулярной встрече, не превращая одну строку в плохо читаемый отчёт.
Публичный шаблон журнала инцидентов в Google Sheets открывается только для чтения. Его можно клонировать через меню «Файл → Создать копию».
Что получилось в пяти инцидентах
В пяти паспортах 2026 года использование Codex указано прямо. Это нижняя граница: инструмент могли применять и в других случаях, не записывая его имя.
Таблицу можно прокрутить по горизонтали.
| Эпизод | Что сделал Codex | Время | Где потребовался человек |
|---|---|---|---|
| Оценка масштаба | Посчитал 288 направлений с резервным расчётом и разделил их на две наблюдаемые причины деградации | 2–3 минуты | Основная причина и восстановление ещё не были подтверждены |
| Разбор воспроизводимой ошибки | Подтвердил, что 29 из 29 попыток завершались одной ошибкой, а три доступных кандидата блокировались защитным условием | Около 64 минут до RCA | Требовались решение владельца и изменение рабочего контура; расследование само сервис не восстановило |
| Инцидент с поздним обнаружением | Начал диагностику примерно в течение минуты и позднее выполнил итоговую проверку | 8 минут 14 секунд до первой успешной авторизации; 15 минут 21 секунда до первого рабочего запроса | Воздействие началось более чем за два часа до регистрации; главный резерв оказался в обнаружении, а не в скорости агента |
| Путь от причины к коду | Примерно за 65 минут подтвердил причину и создал задачу на исправление | Несколько дней до production-релиза | Реализация была агентной, но не только Codex: часть кода сделала другая модель, решение и проверку выполнил человек |
| Риск диагностики | За 81–84 минуты подтвердил ключевые признаки причины по снимку данных | Около четырёх дней до восстановления | Тяжёлый запрос только для чтения вызвал OOMKill — контейнер был принудительно завершён из-за нехватки памяти; рабочую конфигурацию изменил человек |
Пятый эпизод особенно важен: доступ только для чтения не означает отсутствия риска. Диагностическим запросам тоже нужны ограничения по ресурсам и безопасные сценарии запуска.
Что показала проверка всего реестра
К 9 сентября нумерация дошла до PIR-217. В журнале нашлось 214 уникальных строк, из них 197 относятся к 2026 году. Все 13 записей без категории сначала были классифицированы по описанию симптома, влиянию и фактам из соответствующего PIR. Затем 39 записей с предметной меткой «Курсы обмена» были разнесены по типу причины, а отдельные категории сетевых проблем и свойств системы объединены с инфраструктурой и архитектурой соответственно.
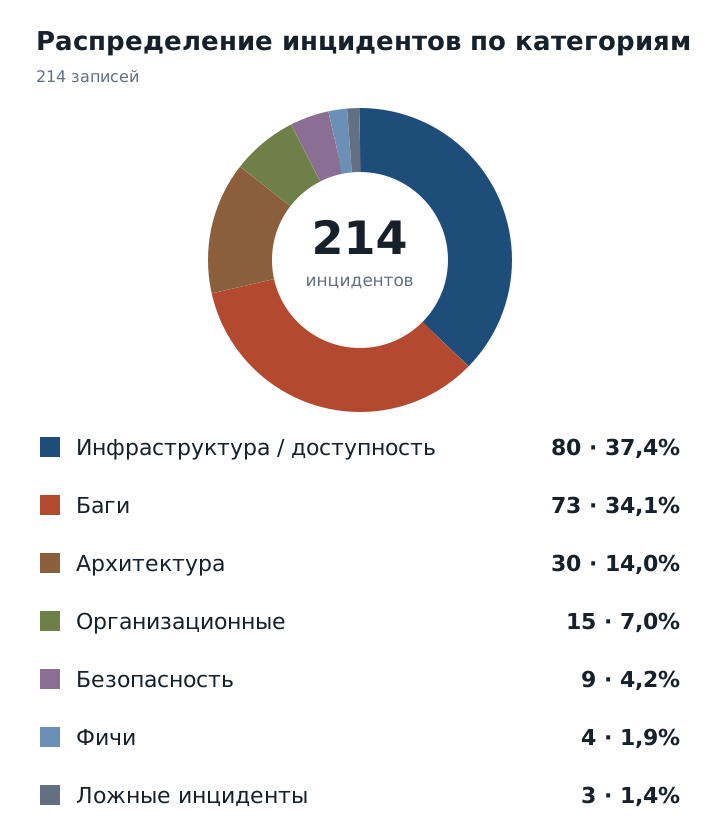
Журнал показывает, что инцидент здесь действительно понимался широко. На инфраструктуру и доступность приходится 80 записей (37,4%), на баги — 73 (34,1%), на архитектурные причины — 30 (14,0%). Вместе это 85,5% реестра; оставшаяся часть включает организационные, связанные с безопасностью, новые функции и ложные инциденты.
До повторной проверки дата восстановления была заполнена лишь у 28 из 214 строк, дата разбора — у 18, дата закрытия — у 101, длительность — у трёх. При этом 201 строка уже была помечена закрытой, поэтому одного статуса было недостаточно, чтобы подтвердить выполнение и проверку всех предотвращающих задач.
Повторный проход по 213 доступным PIR-документам, 23 связанным тредам Mattermost, 189 ссылкам на GitHub Issues и PR, релизным отметкам и сохранившимся логам добавил в журнал 353 подтверждённых значения. После него в таблице есть 92 даты восстановления, 64 даты разбора, 127 дат закрытия, 50 времён первого ответа и 49 длительностей. Для 122 PIR доказанной даты восстановления всё ещё не осталось. Подставлять вместо неё дату merge, issue или ближайшей регулярной встречи было бы удобно, но неправильно.
Этот пробел — тоже результат эксперимента. Автоматизация не создаёт отсутствующее доказательство задним числом. Если команда хочет считать время реакции и восстановления, эти события нужно фиксировать в момент работы, а не реконструировать через несколько месяцев.
Что удалось автоматизировать
| Уровень | Что подтвердил кейс |
|---|---|
| Можно в основном поручить агенту | Сбор хронологии, подсчёт масштаба, проверку гипотез, черновик RCA и поиск пробелов в реестре |
| Только полуавтоматически | Подготовку пути к исправлению, изменение кода и проверку результата — с проверкой человеком и явными критериями приёмки |
| Остаётся за человеком | Выбор допустимого временного решения, принятие риска, действие в production, подтверждение восстановления и закрытие PIR после проверки предотвращающих задач |
Ответ эксперимента
Для AAA ответ такой: полностью автоматически — нет, это не подтверждено; полуавтоматически — да. Codex за минуты оценивал масштаб и за 60–90 минут доводил отдельные расследования до подтверждённой причины, а агентная связка помогала доводить некоторые выводы до кода. Но изменение production, принятие риска, проверка восстановления и закрытие PIR оставались человеческими контрольными точками.
Команда обошлась без отдельного отдела надёжности и специализированной платформы управления инцидентами. Но мы не измеряли снижение среднего времени восстановления (MTTR), человеческих часов или расходов, поэтому нельзя утверждать, что финансовая эффективность уже доказана.
Минимальный повторяемый контур получился таким: один тред → один паспорт PIR → проверенное восстановление → RCA → предотвращающие задачи → закрытие только после их выполнения и проверки. Агент может связать эти этапы доказательствами, но не должен самостоятельно принимать последнее решение.